El núcleo de la red: por qué se corta tu videollamada con fibra de 1 Gbps
Vídeo · 29:54 min · Sesión 1.3 · 15 sep 2026 · Ver en YouTube
capítulos
- 0:00 Por qué se corta tu videollamada
- 0:34 Arquitectura de Redes I, sesión 1.3
- 0:46 El plan de la sesión
- 1:52 Reservar vs compartir
- 4:21 35 usuarios frente a 10
- 7:33 ¿La conexión TCP es un circuito?
- 8:38 La red de redes
- 12:02 El traceroute a Australia
- 12:54 ¿Por qué no hay peering universal?
- 13:43 Los cuatro retardos
- 18:25 Colas, pérdidas y caudal
- 21:55 El diagrama con ACK
- 26:38 Resolviendo el misterio
- 28:05 Resumen para el examen
visualizaciones relacionadas
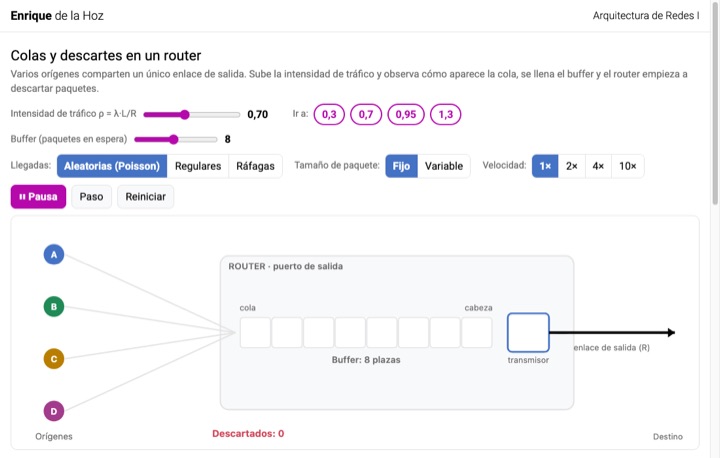
Colas y descartes en un router
Varios orígenes comparten un enlace de salida. Sube la intensidad de tráfico ρ = λ·L/R y mira cómo crece la cola, se llena el buffer y el router empieza a descartar paquetes.
Sesión 1.3English version
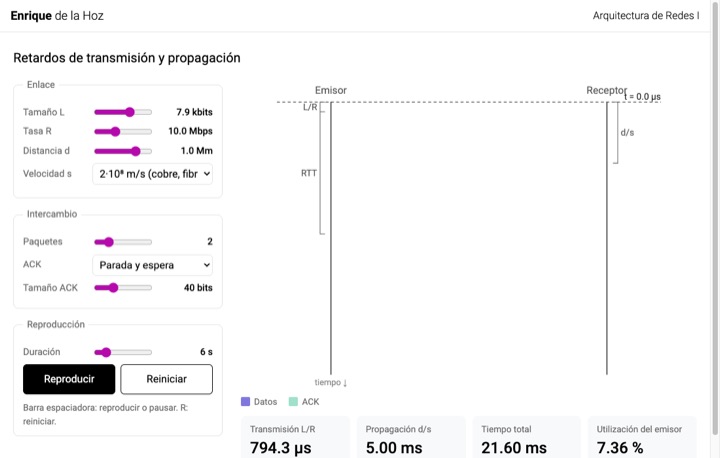
Retardos de transmisión y propagación: diagrama espacio-tiempo
Ajusta tamaño, tasa, distancia y velocidad de propagación y sigue los paquetes entre emisor y receptor. Compara parada y espera con pipelining y la utilización del emisor.
Sesión 1.1English version
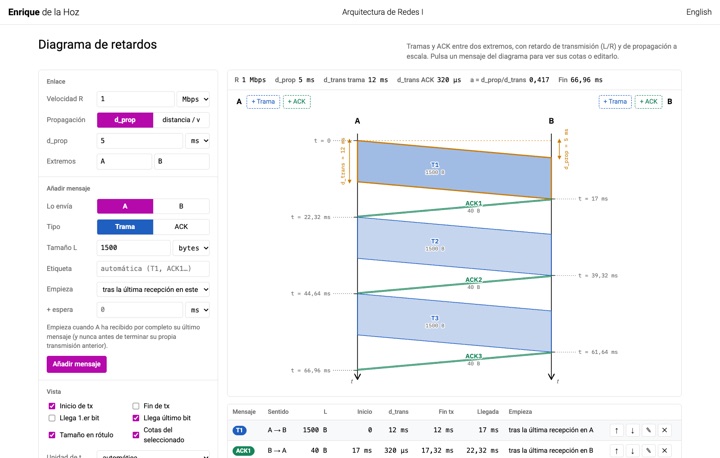
Diagrama de retardos
Dibuja a escala tramas y ACK entre dos extremos y decide cuándo empieza cada uno. Mide en las cotas los retardos de transmisión y de propagación y exporta el diagrama en SVG o PNG.
Sesión 1.3English version
transcripción
Mostrar la transcripción completa, por capítulos
Por qué se corta tu videollamada
Tengo fibra de 1 gigabit. Y sin embargo, la videollamada con mi grupo del proyecto se corta cada dos por tres. ¿Cómo puede ser? Pues puede ser. Y no es culpa de tu fibra.
Para entender por qué, hay que abrir Internet por dentro, ver cómo se reparte un enlace entre millones de personas, por qué caminos va tu tráfico, quién es el dueño de cada uno y, sobre todo, qué es lo que se dispara cuando la red va lenta. Que puede ser que no sea lo que tú crees. Esto es Arquitectura de Redes, sesión 1.3, el núcleo de la red.
Arquitectura de Redes I, sesión 1.3
Al final del episodio sabrás exactamente por qué se congela la llamada y lo sabrás con números.
El plan de la sesión
Hola, esto es el podcast de Arquitectura de Redes. Si has venido a clase, esto es un repaso con otro ritmo. Si no has podido venir, aquí tienes lo esencial de las dos horas en media hora. Ten papel a mano, porque en algún momento te voy a pedir que dibujes conmigo. Vamos a resolver el misterio de antes en tres pasos. Primero, cómo se comparte una red entre millones de comunicaciones.
Segundo, cómo está organizada Internet por dentro, quién se conecta con quién y quién paga a quién. Y tercero, los números. ¿Cuánto tarda un paquete? ¿De qué se compone ese tiempo? ¿Y qué es lo que de verdad se dispara cuando la red va lenta?
Antes de empezar, una idea de sesiones anteriores que hoy vamos a necesitar hasta el final. En la sesión 1.1 calculaste dos tiempos. El retardo de transmisión, que es el tamaño del paquete dividido por la velocidad del enlace, y el retardo de propagación, que es la distancia partido por la velocidad de la señal. Si no lo recuerdas, páralo un momento y míralos. Empezamos.
Piensa en el núcleo de Internet como una malla de routers unidos por enlaces.
Reservar vs compartir
Por esa malla tienen que pasar al mismo tiempo tu videollamada, la descarga de tu compañero y el correo de alguien en otro continente. La pregunta de fondo de estas sesiones: ¿cómo se reparte la capacidad de esos enlaces entre todas esas comunicaciones? Hay dos respuestas históricas. La primera es la del teléfono de toda la vida, la conmutación de circuitos. Cuando descuelgas y marcas, la red busca un camino hasta el destino y en cada enlace de ese camino te reserva un trozo de la capacidad.
Ese trozo es tuyo durante toda la llamada, ¿lo uses o no? A cambio, nadie te lo quita, la calidad es constante y no hay esperas. Fíjate en las tres fases: primero se establece el circuito, luego se usa y al colgar se libera. La segunda es la de Internet, la conmutación de paquetes. Aquí no se reserva nada, la información se trocea en paquetes y cada paquete viaja por su cuenta.
Cuando un paquete llega a un router, el router lo recibe entero, mira la dirección de destino, decide por qué enlace sale y lo transmite. Si ese enlace está ocupado por otro paquete, el nuestro esperará en una cola. Los paquetes de distintas comunicaciones se van intercalando en cada enlace, eso es compartir. Quédate con dos palabras: reservar para circuitos y compartir para paquetes. Ahora, ¿por qué Internet no se hizo con circuitos, si los circuitos garantizan la calidad?
Por una razón que puedes comprobar en cualquier conversación. La mayor parte del tiempo, uno de los dos interlocutores está callado. Un circuito telefónico lleva silencio la mitad del tiempo y en una comunicación de datos es mucho peor. Miras una página web durante un minuto, o una red social, y en ese minuto no envías casi nada. El circuito reservado está vacío y nadie más puede usarlo.
Vamos a ver un ejemplo con números reales. El enlace clásico entre dos centrales telefónicas en Europa es el E1, de 2048 kilobits por segundo. Se divide en 32 circuitos de 64 kilobits por segundo, que es lo que necesita una voz digitalizada. Caben 32 llamadas. La llamada 33 no espera en cola ni va más lenta, directamente se rechaza.
Es el tono de «todas las líneas están ocupadas». Ese es el precio de reservar. Cuando no hay un recurso, hay bloqueo.
35 usuarios frente a 10
En el libro hay un ejemplo que resume todo esto y que conviene saber reproducir. Tenemos un enlace de un megabit por segundo. Cada usuario, cuando está activo, genera 100 kilobits por segundo, pero los usuarios solo están activos el 10% del tiempo, el resto están leyendo, pensando o en silencio. Con conmutación de circuitos cada usuario necesita su reserva de 100 kilobits por segundo, así que caben 10, 10 y ni uno más, aunque 9 de ellos estén callados. Con conmutación de paquetes no reservamos, admitimos por ejemplo 35 usuarios.
¿Cuándo hay problema? Solo cuando más de 10 están activos a la vez, porque entonces generan más de un megabit por segundo y el enlace no da abasto. ¿Pero con qué probabilidad ocurre esto? Esta situación se modela con una distribución binomial, 35 usuarios cada uno activo con una probabilidad de 0,1. La probabilidad de que más de 10 usuarios estén activos a la vez es 0,0004, o dicho de otra manera, 4 entre 10.000 como mucho.
Es decir, el 99,96% del tiempo los 35 usuarios tienen exactamente el mismo servicio que tendrían con un circuito, y son más del triple. A esto se le llama multiplexación estadística. El reparto no está fijado de antemano, depende de cómo se genera el tráfico y funciona precisamente porque el silencio de unos lo aprovechan otros. Ahora repito la pregunta que hice en clase: si en vez de 35 admitimos a 100 usuarios, la intuición nos dice que la probabilidad de saturación debería subir un poco. Sin embargo, la distribución binomial nos dice otra cosa: con 100 usuarios la probabilidad de que más de 10 estén activos a la vez es 0,42, casi la mitad del tiempo.
La razón es sencilla, 100 por 0,1 son 10 activos de media y superar la media ocurre muy a menudo. Conclusión, la conmutación de paquetes permite atender a muchos más usuarios que la de circuitos, pero no a infinitos. Tenemos que dimensionar, y a eso volveremos en la tercera parte cuando hablemos de intensidad de tráfico. Antes de cerrar este bloque, el resumen que debes saber. Circuitos: conllevan la reserva extremo a extremo, un retardo bajo y constante, la ausencia de colas y la calidad garantizada, a cambio de tener que tener en cuenta un tiempo de establecimiento, un desaprovechamiento de recursos que no se están utilizando y la aparición del bloqueo cuando no hay recursos.
Paquetes: no es necesaria la reserva, tenemos un uso en general más eficiente del enlace, no hay bloqueo de la entrada, hay caminos alternativos para cada uno de los paquetes y, a cambio, tenemos que tener en cuenta la aparición de un retardo variable, la gestión de las colas, el fenómeno de la congestión, de pérdidas y de desorden, y la necesidad de incluir una cabecera de control en cada uno de los paquetes.
¿La conexión TCP es un circuito?
Podemos plantear la siguiente pregunta. Justo antes, en la sesión anterior, dijimos que TCP establece una conexión antes de enviar datos. ¿Eso no sería un circuito? La respuesta es que no, y es una de las confusiones más frecuentes en este tema. La conexión TCP es un acuerdo lógico entre los dos extremos.
Se ponen de acuerdo, entre otras cosas, en numerar los datos y en confirmarlos. Ningún router del camino sabe que esa conexión existe y nadie reserva capacidad de ningún enlace. Los paquetes de TCP viajan como cualquier otro, compartiendo, esperando en colas y en ocasiones perdiéndose. Un circuito, en cambio, es una reserva física en cada nodo del camino. Las dos cosas, conexiones y circuitos, tienen tres fases, establecimiento, uso y liberación, y por eso se parecen en la forma.
Pero una es un acuerdo entre dos programas, la conexión, y la otra es un recurso reservado en la red. Si en el examen, por ejemplo en un test, aparecen conexiones y circuitos, ahí está una posible fuente de confusión. Cambiamos de escala.
La red de redes
Hasta ahora hemos hablado de un enlace y unos cuantos routers. Sin embargo, Internet tiene millones de redes de acceso: tu casa, tu operador móvil, la universidad, cada empresa. ¿Cómo se conectan todas con todas? Conectar cada red con cada una de las demás es imposible. Con un millón de redes serían del orden de 500 mil millones de enlaces.
Y tampoco existe un único proveedor mundial al que todos se conecten, porque nadie posee Internet ni la gobierna. Lo que existe es una jerarquía y un conjunto de acuerdos comerciales entre estas redes independientes. Vamos a recorrer esta jerarquía de abajo a arriba. En la base están los ISP de acceso, los que te dan conexión en casa, en el móvil o en la universidad. Cada ISP de acceso contrata a un ISP mayor, regional o nacional, para que lleve su tráfico al resto del mundo.
Y estos ISP regionales contratan a su vez a los ISP de nivel 1. Se trata de una docena de redes de alcance mundial con nombres como Lumen, Cogent, NTT o Arelion, que no pagan a nadie porque llegan a todas partes y se conectan entre ellas de igual a igual. Aquí aparecen los cuatro términos que tienes que dominar. En primer lugar, la relación cliente-proveedor. El ISP cliente paga al proveedor por el tránsito, es decir, porque le lleve y le traiga tráfico de todo Internet.
Tú pagas a tu operador y tu operador paga a un proveedor de nivel 1. Segundo, el punto de presencia, el POP. Un POP es un grupo de routers del ISP proveedor situados en un lugar concreto. Por ejemplo, un edificio en Madrid al que el ISP cliente conecta sus propios routers, normalmente a través de una línea alquilada o con fibra propia. El POP es donde se produce la conexión cliente-proveedor.
No es una red privada de contenidos, no es gratis y no sustituye a nadie. Es la puerta de entrada a la red del proveedor. Tercero, multi-homing. Un ISP, o una empresa grande, se conecta a dos o más proveedores. Si uno falla, sigue conectado y, de paso, le permite mejorar y negociar mejores precios.
Por último, el peering. Hablamos de peering cuando dos ISP del mismo nivel se conectan directamente y se intercambian el tráfico de sus clientes sin pagarse nada. ¿Por qué? Porque los dos ahorran: el tráfico entre un cliente de Movistar y un cliente de Digi, por decir dos nombres, no tiene por qué subir hasta un nivel 1 y pagar tránsito dos veces. Cuando el peering se hace a lo grande, en un edificio con un conmutador al que se conectan cientos de redes, estamos hablando de un punto de intercambio de Internet o IXP.
En España, por ejemplo, tenemos ESpanix, con más de mil redes conectadas. Ahora, el ingrediente que el dibujo clásico no tiene y que hoy es el más importante. Las redes de proveedores de contenido, Google, Meta, Netflix, Amazon o Microsoft, operan redes privadas mundiales que unen sus centros de datos y no se conectan a Internet por arriba pagando a un nivel 1. Se conectan por abajo. Hacen peering directamente con los ISP de acceso y en los IXP y además instalan servidores dentro de la red de los operadores.
Cuando ves una serie en casa, el vídeo casi seguro que no ha subido a ningún nivel 1. Ha ido de la red de Netflix a tu operador en un salto, o desde una máquina de Netflix que está físicamente dentro de la red de tu operador.
El traceroute a Australia
Lo hacen por dos motivos: no pagan tránsito y así permiten controlar el retardo hasta tu domicilio. Y por último, vuelve el traceroute que hicimos en la primera sesión de la asignatura, el que iba de la universidad a un servidor en Australia. Los tres primeros saltos eran routers de la UAH, nuestra red de acceso. Los saltos 4 y 5 eran RedIRIS, la red académica española, nuestro proveedor de acceso a Internet. Los saltos 7 a 10 eran GÉANT, la red académica europea.
Luego observábamos un salto en el que el tiempo pasaba de 28 a 195 milisegundos. Esto se corresponde con un cable submarino hasta Australia. Y los últimos saltos ya dentro de AARNet, la red académica australiana, que nos llevan hasta el servidor. 5 redes, 5 dueños y ninguna de ellas es Internet. Internet es que esas 5 se hayan puesto de acuerdo en pasarse los paquetes.
¿Por qué no hay peering universal?
Podemos plantearnos la siguiente pregunta: si en el peering nadie paga, ¿por qué no hacen peering todos con todos y se acaba el tránsito? Esto es así porque el peering solo compensa cuando los dos ganan algo parecido. Un ISP pequeño que quiera peering con uno enorme le está pidiendo, en la práctica, que le lleve tráfico gratis a sitios a los que él no llega. El grande dirá que no, dado que pierde un negocio, y por tanto perdería la posibilidad de venderle tránsito al ISP pequeño. El peering, en la práctica, solo se da entre redes de tamaño similar o cuando el grande tiene interés propio, por ejemplo, con los proveedores de contenido que quieren estar cerca de los usuarios.
Se trata de una decisión comercial, no de una decisión técnica. Y ahora sí, la pieza que nos falta para resolver el misterio de la videollamada. Comenzamos con la segunda parte de la sesión. Bueno, es la tercera, pero es la segunda donde aparecen los números. A partir de aquí, todo van a ser cálculos.
Los cuatro retardos
Definimos el retardo extremo a extremo como el tiempo que pasa desde que el origen empieza a transmitir un paquete hasta que el destino recibe su último bit. En cada nodo del camino, este tiempo se compone de cuatro trozos. En primer lugar, el retardo de procesamiento. El router mira la cabecera, comprueba que no hay errores y decide por qué enlace sale el paquete. Estamos hablando de microsegundos.
En los problemas, casi siempre despreciaremos este retardo. En segundo lugar, el retardo de cola. Si el enlace de salida está ocupado, el paquete espera. Este es el único de los cuatro que no se puede calcular con una fórmula fija porque depende de cuántos paquetes hayan llegado antes. Es un retardo de naturaleza estadística y es el que hace que la red vaya a ratos o a tirones.
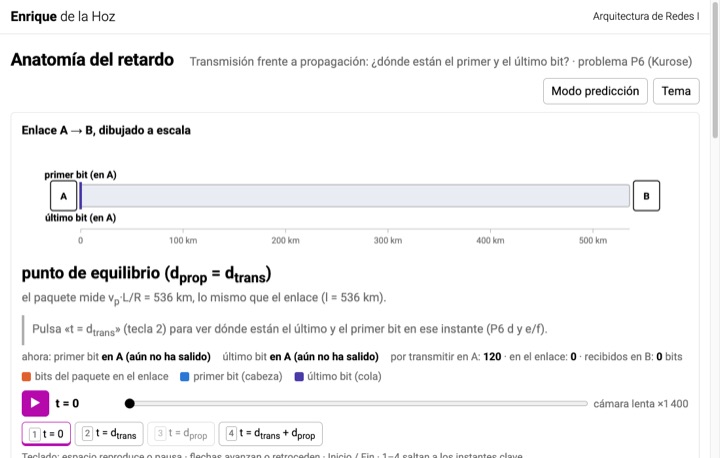
Tres, el retardo de transmisión. Es el tiempo que tarda el router en poner en el cable todos los bits del paquete, la longitud del paquete partido por la velocidad del enlace. L dividido por R. Un paquete de 1500 bytes, que son 12.000 bits, en un enlace de 10 megabits por segundo, tarda 1,2 milisegundos en transmitirse. Y cuarto, el retardo de propagación.
Es lo que tarda la señal en recorrer el enlace. La distancia, el tamaño del enlace, dividido por la velocidad de la señal, que en la fibra y en el cobre es de unos 200 mil kilómetros por segundo, más o menos dos tercios de la velocidad de la luz en el vacío. Mil kilómetros de fibra son unos 4 o 5 milisegundos, según el valor que os demos para la velocidad de propagación. Fíjate en que transmisión y propagación no tienen nada que ver entre sí. La transmisión depende del tamaño del paquete y de la velocidad del enlace, mientras que la propagación depende solo de la distancia.
Un enlace de 100 gigabits por segundo hasta Australia tiene un retardo de transmisión minúsculo y un retardo de propagación enorme. Eran los 170 milisegundos del traceroute que hemos visto. Para que se te quede, la analogía de la caravana del libro. Una caravana de 10 coches es un paquete. Cada coche es un bit.
Un peaje que tarda 12 segundos en atender a cada coche es el transmisor. La caravana entera tardaría dos minutos en pasar. Entre ese peaje y el siguiente hay 100 kilómetros y los coches van a 100 kilómetros por hora. Por tanto, tendríamos una hora de propagación. El retardo total hasta el segundo peaje sería 62 minutos.
Y ahora, una versión con datos más similares a los que podríamos encontrar en un examen. Supongamos que los coches van a mil por hora y que el peaje tarda un minuto por coche. El primer coche llega al segundo peaje a los siete minutos, uno de peaje y seis de carretera. En ese momento, en el primer peaje todavía quedan tres coches por salir. Es decir, el primer bit del paquete ha llegado al destino antes de que el origen haya terminado de transmitir el último.
Esto sucede cuando el retardo de transmisión es mayor que el retardo de propagación. Algo que se da cuando tenemos enlaces cortos o paquetes grandes. Apúntalo, porque es una pregunta que ha aparecido en algunos exámenes. Falta una idea que une la primera parte con esta, el almacenamiento y reenvío. Un router no empieza a reenviar un paquete hasta que lo ha recibido entero.
Esto significa que en cada salto tenemos que tener en cuenta un retardo de transmisión completo. Si un camino tiene dos enlaces iguales de mil kilómetros a diez megabits por segundo y mandamos un paquete de 1500 bytes, el retardo total no es 1,2 más 4, es dos veces 1,2 más dos veces 4. Queda un total de 10,4 milisegundos, un retardo de transmisión y un retardo de propagación por cada salto. Y si mandamos varios paquetes seguidos, ¿hay alguna fórmula general que lo describa? Con n enlaces y p paquetes, el retardo es (n + p − 1) multiplicado por el retardo de transmisión, más n veces el retardo de propagación. ¿Por qué?
Porque en el primer paquete tenemos que tener en cuenta todos los saltos, mientras que cada paquete siguiente solo añade un retardo de transmisión, ya que va en cadena detrás del anterior. Comprueba que con un solo enlace sale p veces el retardo de transmisión más una vez el retardo de propagación, que es la forma que ya hemos usado en la asignatura. Volvamos al retardo de cola, que es el que hemos dicho que no tiene fórmula.
Colas, pérdidas y caudal
Aunque no podamos calcularlo exactamente, sí que podemos saber intuitivamente cuándo va a ser grande. Sea a el número de paquetes por segundo que llegan al enlace, L el tamaño de cada paquete en bits, y R la velocidad del enlace. El producto L por a son los bits por segundo que llegan, y R son los bits por segundo que el enlace puede procesar. Al cociente, L por a dividido por R, se le denomina intensidad de tráfico, y es el número más útil de esta parte. Si esta intensidad es mayor que uno, llegan más bits de los que salen.
La cola crece sin límite, o mejor dicho, crece hasta que se desborda y comienzan a perderse paquetes. Ningún enlace puede funcionar así de forma sostenida. Si la intensidad es menor o igual que uno, depende de cómo lleguen los paquetes. Si llegaran uno cada cierto tiempo, perfectamente espaciados, no habría cola nunca. Pero, en el mundo real, el tráfico llega a ráfagas, y con ráfagas hay cola, aunque la media sea baja.
Lo importante es la forma de la curva. El retardo medio en cola es pequeño con intensidades bajas, y se dispara cuando la intensidad se acerca a uno. No crece de forma lineal, crece cada vez más deprisa. Por este motivo, los operadores dimensionan sus enlaces para trabajar en torno al 50 o 60% de carga, no al 99%. Un ejemplo rápido.
Supongamos un enlace de 10 Mbps, paquetes de 1.500 bytes, por tanto, 12.000 bits. Si llegan 500 paquetes por segundo, la intensidad es 12.000 por 500, partido por 10 millones: 0,6. Bien. Sin embargo, si llegan 900 por segundo, sale 1,08. Por tanto, una cola infinita y pérdidas aseguradas. Cuando la cola se llena, ¿qué pasa con los paquetes que llegan al router?
Se descartan, punto. El buffer, es decir, el espacio que tiene el router para almacenar estos paquetes, tiene un tamaño finito. Que el paquete se recupere o no ya no es cosa del router. Puede ser retransmitido por el nodo anterior, puede ser retransmitido por el origen si se emplea un protocolo fiable como TCP, o puede que no lo retransmita nadie. Es lo que sucede con el vídeo en directo: cuando llega un paquete tarde ya no nos sirve y, por tanto, no es interesante retransmitirlo.
Última magnitud de la sesión, el caudal o tasa de transferencia (throughput). Es sencillo: bits útiles transferidos, partido por el tiempo que ha costado. En la sesión de capas lo definimos por capa, como la SDU partido por su tiempo. Aquí es la misma idea aplicada al camino completo. Lo único que hay que entender es el cuello de botella.
Si un fichero va del servidor al cliente pasando por un enlace de dos megabits por segundo y luego por otro de un megabit por segundo, el caudal es un megabit por segundo, el mínimo de los dos. El router del medio almacena lo que le sobra, pero no puede acelerar nada. Un fichero de 32 megabits tarda 32 segundos, no 16 y tampoco 48, porque los dos enlaces trabajan a la vez, no uno después del otro. Y si un enlace del núcleo lo comparten n conexiones a la vez, cada una ve como mucho R repartido por n. Hoy, con el núcleo sobredimensionado, el cuello de botella suele estar en el acceso.
Es decir, en tu enlace, no en el enlace que está en medio.
El diagrama con ACK
Vamos a terminar con la herramienta que vamos a usar en el grupo pequeño y en la resolución de ejercicios, el diagrama temporal. Coge un papel y dibuja dos líneas horizontales: arriba al cliente y abajo al servidor. El tiempo crece de izquierda a derecha. En el laboratorio o en el grupo pequeño a veces lo representaremos mediante dos líneas verticales paralelas. Aquí elegiremos dos líneas horizontales para hacerlo visualmente más fácil de representar.
Veamos los datos. 500 kilómetros de distancia, velocidad de propagación 2,5 por 10 elevado a 8 metros por segundo. Tenemos un enlace de 5 megabits por segundo y queremos transmitir dos tramas de 1000 bytes seguidas. Además, se enviarán asentimientos de tamaño 60 bytes. Comenzamos calculando el retardo de propagación.
El retardo de propagación es la inclinación de todo lo que vamos a dibujar. 500 mil entre 2,5 por 10 a la 8, eso da 2 milisegundos. Pasamos a la transmisión. Tenemos 8 mil bits entre 5 millones, eso nos da 1,6 milisegundos. Y por último, la transmisión del asentimiento, del ACK: 480 bits entre 5 millones, eso nos da 0,096, un retardo muy pequeño pero superior a 0.
Ahora vamos a dibujar la trama 1. Se trata de un paralelogramo que sale de arriba en el instante 0, termina de salir en 1,6 y llega abajo, inclinado, 2 milisegundos después, entre los instantes 2 y 3,6. La trama 2 se transmite inmediatamente a continuación de la trama 1, sale en el instante 1,6 y termina de salir en el instante 3,2 y llega desde el instante 3,6 al instante 5,2. ¿Y qué sucede con el asentimiento de la primera trama? El asentimiento de la primera trama es enviado por el receptor a partir del instante 3,6, en cuanto el servidor tiene el último bit, tarda en enviarlo 0,096 y tarda 2 milisegundos en llegar hasta el emisor, llegando arriba en 5,7.
Lo mismo con la segunda: desde 5,2, por tanto, llegaría en 7,3 milisegundos. Ese sería el retardo que pide el problema. Teniendo este valor podemos calcular el caudal de aplicación: 16.000 bits útiles entre 7,3 milisegundos, unos 2,2 megabits por segundo sobre un enlace de 5 megabits por segundo. Perdemos más de la mitad únicamente por la propagación y la espera del ACK. Ahora tenemos la variante que también se pregunta, parada y espera.
El cliente en esta variante no enviará la trama 2 hasta que haya recibido el ACK, el asentimiento de la trama 1. Calculemos: 1,6 más 2 más 0,096 más 2, en total 5,7 milisegundos por cada una de las dos tramas, en total 11,4 milisegundos. Con este retardo el caudal baja a 1,4 megabits por segundo. Esto quiere decir que el enlace está parado casi tres cuartas partes del tiempo esperando confirmaciones, este es el coste de emplear parada y espera y es un problema que se agrava con la distancia. En el tema 3 veremos cómo podemos mejorar este rendimiento mediante la utilización de ventanas, que permiten enviar varias tramas antes de esperar. Si has hecho el dibujo, compáralo con la transparencia correspondiente de grupo grande.
Hay tres errores típicos. El primero, dibujar la trama como una única línea, olvidando el retardo de transmisión. El segundo, empezar la segunda trama cuando llega la primera, que es confundir el envío seguido con la parada y espera. Y el tercero, olvidar también que el ACK tiene retardo de transmisión, por pequeño que sea. Volvamos a tu videollamada. Tienes un gigabit. ¿Cuánto necesito para una videollamada? 2, 3 megabits por segundo.
Resolviendo el misterio
El caudal sobra por 300 veces. Entonces, ¿qué es lo que provoca el fallo? Es el retardo de cola lo que provoca el fallo. En algún enlace del camino, que casi seguro que no es el enlace de acceso, la intensidad de tráfico se acercará a uno durante unos segundos. Puede ser el wifi de tu casa, que es un enlace compartido más, pero también puede ser el enlace del operador con un punto de intercambio en hora punta.
También puede ser en otros medios compartidos, por ejemplo, en un piso de estudiantes o en la universidad, cuando hay muchos usuarios compartiendo la misma red. Cuando la intensidad se acerca a uno, la curva que vimos se dispara. Unos paquetes llegan tarde y otros ni siquiera llegan. Se pierden porque no pueden ser almacenados en una cola de tamaño finito. Y la videollamada, como hemos visto, no espera a un paquete tarde.
El paquete no llega y lo observamos como un vídeo que se congela. Fíjate en que nada de esto lo arregla tu gigabit por segundo. El cuello de botella manda y el cuello de botella puede estar en otro sitio. Y nada de esto pasaría con un circuito reservado, pero entonces solo cabrían 10 usuarios, no 35. Es la solución de compromiso a la que llegó Internet.
Compartir en lugar de reservar.
Resumen para el examen
Voy a tratar de resumir esta sesión en seis frases. Una, con conmutación de circuitos, cosas a tener en cuenta: reserva extremo a extremo, retardo constante, recursos ociosos y bloqueo. Dos, con conmutación de paquetes: sin reserva, modo de almacenamiento y reenvío, multiplexación estadística, retardo variable y aparición de pérdidas. Pero muchos más usuarios, 35 frente a 10 en nuestro ejemplo.
Tres, Internet es una red de redes: redes de acceso, redes regionales, redes de nivel 1. Hemos hablado de puntos de presencia, hemos hablado de multi-homing, de peering y de puntos de intercambio. Y finalmente, hemos hablado de las redes de contenido que se conectan directamente al acceso. Cuatro, el retardo extremo a extremo es la suma en cada nodo de los retardos de procesamiento, cola, transmisión y propagación. Transmisión es L partido por R, propagación es distancia partido por velocidad.
Y debido al modo de funcionamiento de almacenamiento y reenvío, tenemos que tener en cuenta un retardo de transmisión adicional por cada uno de los saltos. Cinco, la intensidad de tráfico, L multiplicada por a dividida por R, tiene que ser claramente menor que 1. Cuando nos aproximamos a 1, el retardo de cola se dispara y la cola finita obliga a descartar paquetes. Seis, el caudal extremo a extremo vendrá determinado por el enlace que actúe de cuello de botella, y la aparición de los asentimientos también reduce el caudal efectivo. Otras cosas que puede ser interesante que repases: repasa el concepto de segmentación y ten claro el diagrama temporal.
Nos vemos en la siguiente sesión.